Harness 场景与组合架构
调研快照:2026-09-26。这里的 harness 指把模型、上下文、工具、权限、环境、状态、评测和发布组织成可重放运行时,而不是一个聊天 UI。
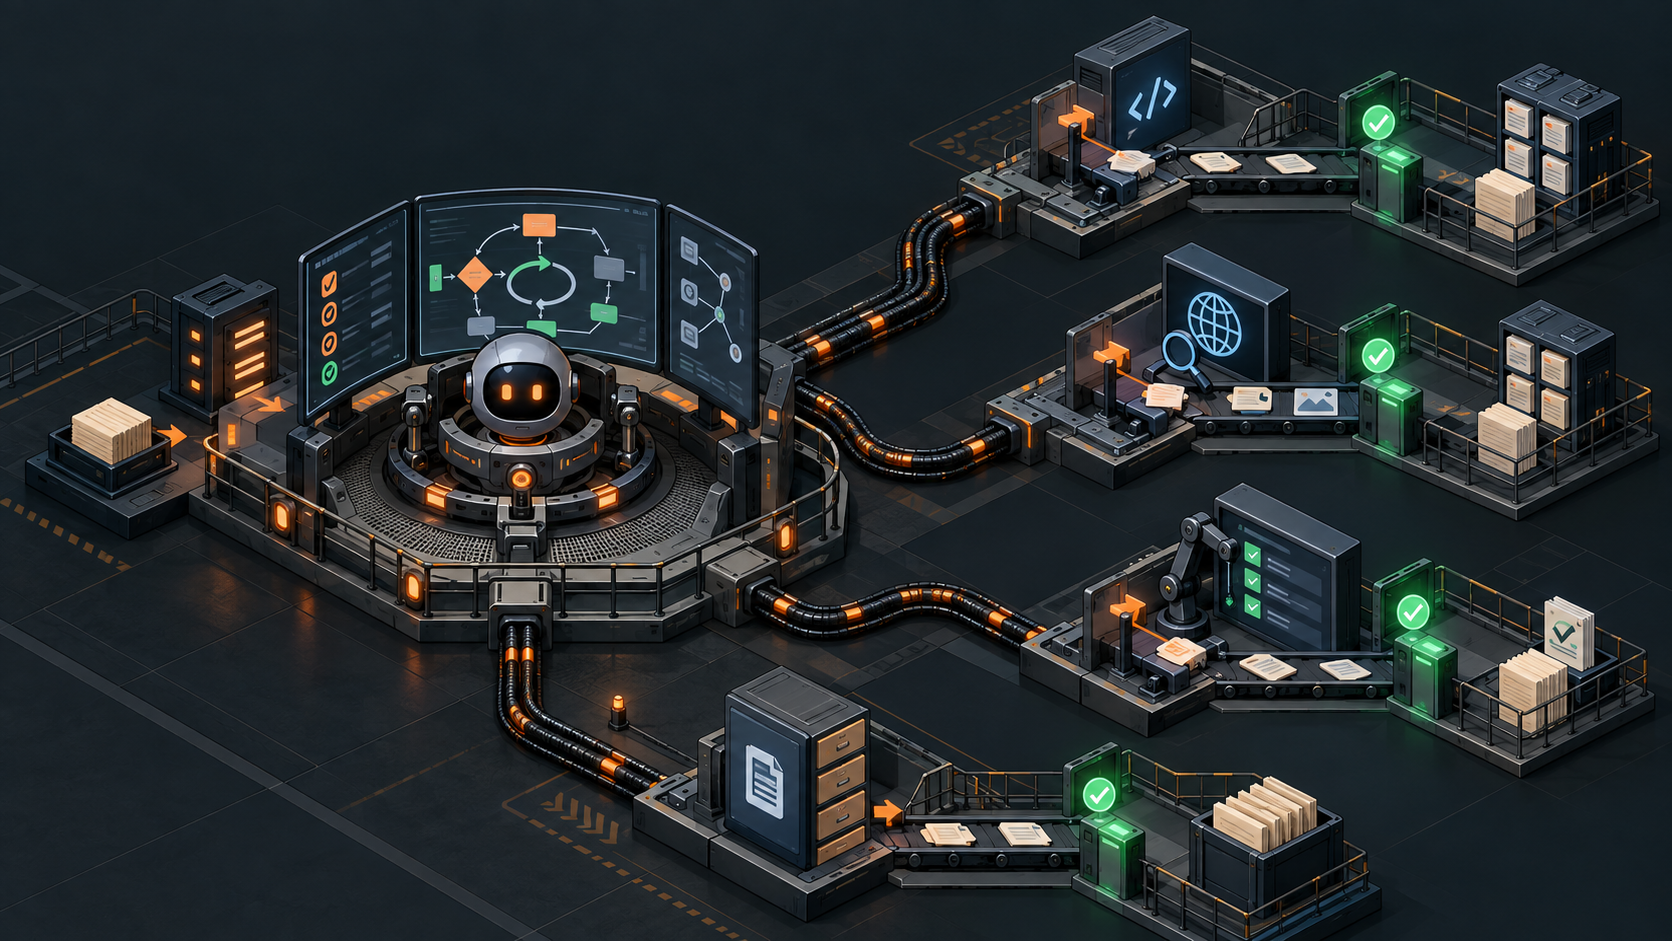
统一运行时
输入/任务
  -> policy 与预算
  -> context 装配(项目指令、检索、历史、记忆)
  -> model router(主模型、fallback、judge)
  -> tool call / sub-agent
  -> sandbox、网络、凭证与副作用控制
  -> append-only trace、diff、工件
  -> judge/eval gate
  -> 人工批准、发布或回滚
任何一步缺失,系统就会退化成“模型能调用工具”,但无法解释为什么成功、为什么越权、为什么下次复现不了。
六类近期场景
1. 代码修复与升级
逻辑:读取仓库规则 → 搜索/测试 → 小补丁 → lint/test → 生成 diff → 人工批准。
适合:Codex、OpenCode、pi、Gemini CLI、Qwen Code。
关键门禁:默认只读;写操作需要审批;测试失败不能自动宣称完成;保存命令、环境、diff 和测试输出。
2. 浏览器研究与资料交付
逻辑:检索白名单 → 抓取正文 → 去重/引用 → 观点与证据分离 → judge 检查引用覆盖率 → 发布 Markdown。
适合:dsh 的插件/事件组合,或任一 coding harness 加浏览器工具。
关键门禁:域名白名单、网页快照、来源日期、禁止把搜索摘要当原文;外部发布必须人工确认。
3. 企业 RAG 与工单处理
逻辑:租户鉴权 → 文档过滤 → 检索与重排 → 工具动作 → 结构化回复 → 审批/回写。
适合:dsh 的可组合 kernel + pi/Qwen 的模型 adapter;需要把租户、凭证和审计放在 harness 层。
关键门禁:检索结果带 ACL;写入动作幂等;模型不能直接拼接 SQL 或调用未声明 API。
4. CI / 修复回路
逻辑:失败日志归一化 → 生成候选补丁 → 隔离 runner 验证 → 只上传 patch/report → 人工合并。
适合:Codex/OpenCode/pi 的 headless/RPC 模式。
关键门禁:runner 无生产凭证;网络最小化;限制 token、时间和 diff 大小;重复失败自动停止。
5. 长时研究与多 Agent
逻辑:任务图 → specialist worker → peer reviewer → 汇总 → 发布器。
适合:Muse 类 orchestrator;dsh 负责插件化执行;pi 负责轻量 worker。
关键门禁:每个 worker 有独立预算和角色;reviewer 不能无证据覆盖结论;任务图、输入和中间产物可恢复。
6. 评测、守门与自动回归
逻辑:固定任务集 → 多模型/多 harness 跑 trace → judge + 规则 grader → 人工抽样 → 发布版本门禁。
适合:所有 Agent;尤其适合对比 Claude、Gemini、DeepSeek、Qwen、Kimi、GLM、ChatGPT。
关键门禁:执行模型与 judge 解耦;保留 judge 解释与置信度;高风险样本必须人工复核。
一个值得复盘的最新案例:MiniMax M2.7
MiniMax 的公开材料把 M2.7 描述为能够构建复杂 Agent harness、组合 Agent Teams/skills/memory,并在“分析失败轨迹 → 修改 scaffold → 跑评测 → 比较 → 保留或回滚”的循环中迭代。这个案例的价值不在于直接接受厂商的提升数字,而在于它给出了一个可研究的闭环:harness 本身成为实验对象。
FDE 复盘时应把“模型修改了什么”与“harness 修改了什么”分开版本化,固定任务集和评测环境,保留每轮 diff、失败轨迹、回滚点和人工批准。否则所谓 self-evolution 可能只是任务分布、提示词或评测口径变化。
组合方案:本 Wiki 推荐的 FDE 基线
| 层 | 推荐 | 为什么 |
|---|---|---|
| Orchestrator | dsh 或自建最小 state machine | 插件、profile、事件和可替换能力清晰 |
| Coding worker | Codex / OpenCode / pi / Qwen Code | 分别覆盖安全、provider、嵌入和中文生态 |
| Model router | OpenAI-compatible adapter + 明确 fallback | 将 model ID、reasoning、上下文和价格纳入配置 |
| Tool plane | MCP/ACP + typed tool registry | schema、超时、权限和版本可检查 |
| Execution | 容器/VM/临时 worktree | 代码、网络、凭证和副作用隔离 |
| Trace | JSONL/event log + diff + artifact store | 可重放、可审计、可归因 |
| Judge | 规则 grader + 独立模型 judge + 人工抽样 | 防止单一模型自评和 reward hacking |
不要把所有能力一次性塞进一个 Agent。先让单任务能重放,再引入 fallback、并行 worker 和自动发布。
实施顺序
- 先做单 Agent、只读工具、固定仓库:跑通 20 个代表性任务,建立成功定义。
- 加入写操作和 sandbox:记录审批、命令、网络、文件 diff 和回滚。
- 加入第二模型与 judge:只改变 provider,验证 harness 行为是否稳定。
- 加入长任务/多 Agent:给每个 worker 单独预算,限制递归和并发。
- 接入 CI 与发布门禁:让 artifact、trace、评测和人工批准成为必需产物。
选型判断
适用条件:你需要交付而不是只演示聊天,且能维护任务集、权限策略和运行日志。
代价:harness 会增加工程量、存储、延迟和运维责任;多 Agent 还会放大 token 与故障面。
验证方式:用同一任务集比较成功率、人工接管率、越权率、p95 延迟、每成功任务成本和恢复时间;所有结论都来自 trace,不来自主观体验。
每周追踪表
| 字段 | 记录内容 |
|---|---|
| Runtime | harness commit、配置 hash、容器镜像 |
| Model | model ID、provider、reasoning/temperature、上下文上限 |
| Tools | tool schema、权限、超时、网络和凭证版本 |
| Trace | session ID、步骤、token、命令、diff、错误、人工操作 |
| Eval | 任务集版本、规则 grader、judge 版本、人审样本 |
| Decision | 通过/暂停/回滚、适用条件、代价、验证证据 |
可落地的 Harness 最小协议
不同项目可以使用不同模型和 CLI,但建议把下面的事件协议固定下来,避免每个 Agent 都有一套无法比较的日志:
{
  "run_id": "run-2026-09-26-0042",
  "parent_run_id": null,
  "task": "fix-regression",
  "model_requested": "deepseek-flash",
  "model_observed": "<provider-returned-id>",
  "harness_revision": "git-sha",
  "policy_revision": "policy-v7",
  "events": [
    {"type": "context_loaded", "source": "repo", "sha256": "..."},
    {"type": "tool_call", "name": "read_file", "approval": "implicit"},
    {"type": "tool_result", "exit_code": 0, "bytes": 1842},
    {"type": "patch_created", "files": ["src/a.ts"]},
    {"type": "eval", "status": "passed", "dataset": "golden-v3"}
  ],
  "final_status": "needs_human_approval"
}
四个必须分离的控制面
| 控制面 | 负责什么 | 不应交给模型的部分 |
|---|---|---|
| Policy | 租户、工具 allowlist、网络、预算和审批 | 最终权限判定、凭证发放 |
| Context | 项目规则、检索、历史、文件和记忆 | 可信等级、ACL 和敏感字段过滤 |
| Execution | sandbox、超时、取消、幂等、回滚 | 进程隔离和系统调用边界 |
| Evidence | trace、diff、评测、人工改判和发布记录 | 日志保留、脱敏和审计完整性 |
模型可以提出动作,但 policy 和 execution 决定动作是否能发生。把二者写在 system prompt 里不算安全控制。
源码阅读的固定问题
分析 dsh、pi、Muse、OpenCode、Codex 或相邻 Agent 时,不要只读 README。每个仓库至少回答:
- provider adapter 如何把流式、reasoning、tool call 和取消映射成统一事件?
- 工具 schema、权限审批和网络限制是在模型调用前还是调用后生效?
- session 是追加式日志、快照、树状分支还是数据库记录?能否 fork 和 replay?
- 子 Agent 是否继承父级权限、上下文和凭证?是否有预算上限?
- headless/SDK 模式是否与 UI 模式使用同一条安全路径?
- 仓库公开的是什么,哪些能力仍在托管服务或闭源二进制中?
把答案记录到每个 Agent 的追踪表中,source path + commit 比“官方支持”更有用。
适用条件:要把个人 coding CLI 变成团队服务,或比较多个 Agent 的真实工程边界。 代价:需要统一事件 schema、审计存储和回放 runner。 验证方式:对同一脱敏任务分别运行 UI、headless 和 SDK,比较工具事件、权限结果、退出原因和最终工件是否一致。